Linux e SSH
MySQL daemon failed to start e "Another MySQL daemon already running": como resolver
O erro só diz que o banco não subiu; a causa está no log do MySQL. Reproduzimos no MySQL 8.4 e no MariaDB 11.8 as falhas mais comuns (permissão, outro daemon no socket, trava de arquivo, porta ocupada, disco cheio) e mostramos como ler o log e corrigir cada uma.
- Por equipe técnica da Hospedagem Segura
- Atualizado em 10/10/2026
- 9 min de leitura
Texto do artigo
Neste artigo
- O que significa "MySQL daemon failed to start" em 2026
- Onde ver o motivo real: status, journalctl e o log do MySQL
- Permissão no diretório de dados (errno 13)
- "Another MySQL daemon already running with the same unix socket"
- Porta 3306 ocupada
- Disco cheio (Error number 28)
- InnoDB corrompido: innodb_force_recovery como último recurso
- Perguntas frequentes
"MySQL daemon failed to start" quer dizer só que o serviço do banco não subiu; o motivo de verdade está no log de erros do MySQL. Nos servidores atuais, com systemd, a mesma situação aparece como "Job for mysqld.service failed because the control process exited with error code". Leia as últimas linhas do log, ache a causa e corrija só ela: permissão no diretório de dados, disco cheio, outra instância usando o socket ou os arquivos, porta 3306 ocupada ou InnoDB danificado.
Não rode mysql_install_db nem mysqld --initialize para "consertar": isso cria um banco vazio. A ferramenta mysql_install_db foi removida no MySQL 8.0, e o mysqld --initialize se recusa a rodar num diretório de dados com arquivos. Todos os erros deste guia foram reproduzidos de verdade, com MySQL 8.4 e MariaDB 11.8 no AlmaLinux 9, e as saídas mostradas são as reais.
O que significa "MySQL daemon failed to start" em 2026
As frases "MySQL Daemon failed to start" e "Another MySQL daemon already running with the same unix socket" vinham dos scripts de inicialização antigos (SysV), como os do CentOS 6. Hoje quem controla o serviço é o systemd, e o nome do serviço e o caminho do log mudam conforme o sistema:
- AlmaLinux, Rocky Linux e RHEL com MySQL do repositório do sistema: serviço mysqld, log em /var/log/mysql/mysqld.log.
- AlmaLinux e Rocky com MariaDB: serviço mariadb, log em /var/log/mariadb/mariadb.log.
- Ubuntu e Debian com MySQL: serviço mysql, log em /var/log/mysql/error.log.
- Servidores cPanel: a documentação da cPanel indica /var/log/mysqld.log para MySQL 5.7 ou mais novo e MariaDB 10.3 ou mais novo.
Se o arquivo não estiver aí, o caminho certo está na linha log-error (ou log_error) do my.cnf.
Vale também conferir a versão. O MySQL 8.0 chegou ao fim do suporte da Oracle em abril de 2026. Hoje há duas séries de longo prazo (LTS): a 8.4, que o AlmaLinux 9 oferece no próprio repositório (dnf module enable mysql:8.4 antes do dnf install mysql-server), e a 9.7, lançada pela Oracle em 21 de abril de 2026. Os testes deste guia usam a 8.4.
Onde ver o motivo real: status, journalctl e o log do MySQL
Comece pelo systemctl status. Ele mostra qual etapa falhou e, às vezes, o código do erro:
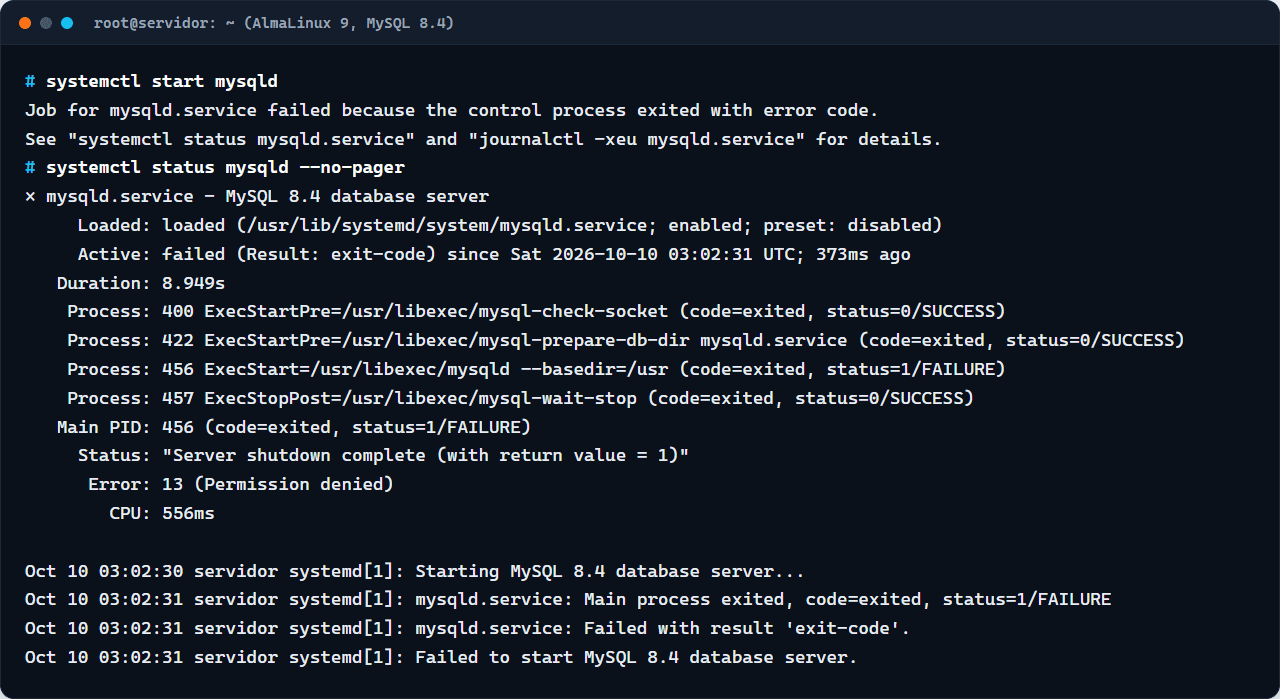
O journalctl -u mysqld -n 50 --no-pager mostra o histórico do serviço e as mensagens dos scripts que rodam antes do MySQL. Já o motivo exato quase sempre está só no log de erros do próprio MySQL:
tail -n 30 /var/log/mysql/mysqld.log
grep ERROR /var/log/mysql/mysqld.log | tail -n 20Leia de baixo para cima: a última linha costuma ser "Aborting", e a causa vem logo antes.
Permissão no diretório de dados (errno 13)
É a causa mais comum depois de restaurar um backup ou copiar o diretório de dados como root. No teste, bastou um chown errado em /var/lib/mysql para o MySQL 8.4 abortar com "OS errno 13 - Permission denied":
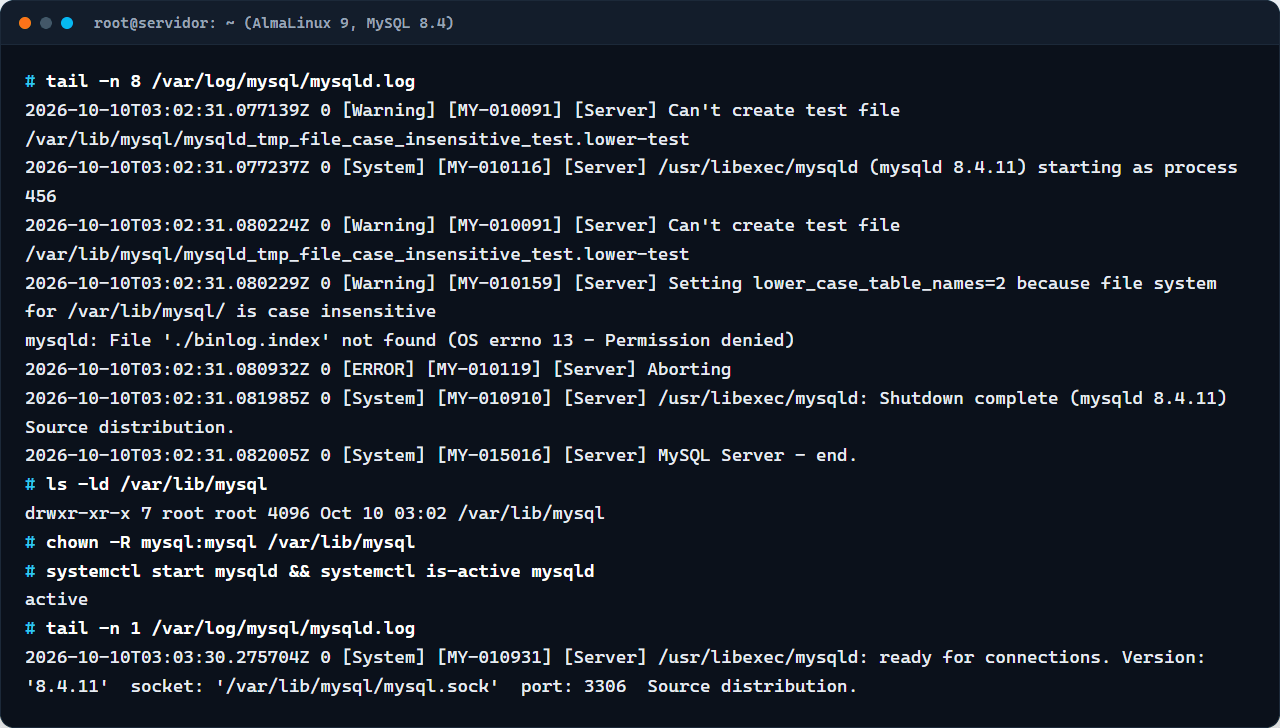
A correção é devolver o diretório ao usuário do banco. Com SELinux ativo, restaure também o contexto dos arquivos, principalmente se o diretório foi movido ou copiado de outro lugar:
chown -R mysql:mysql /var/lib/mysql
restorecon -Rv /var/lib/mysql
systemctl start mysqld"Another MySQL daemon already running with the same unix socket"
No AlmaLinux e no Rocky, antes de iniciar o banco, o systemd roda um script que confere o socket /var/lib/mysql/mysql.sock (mysql-check-socket no MySQL, mariadb-check-socket no MariaDB). Se algum processo está usando o socket, o serviço nem tenta subir. No MariaDB 11.8, a mensagem é praticamente a dos tutoriais antigos:
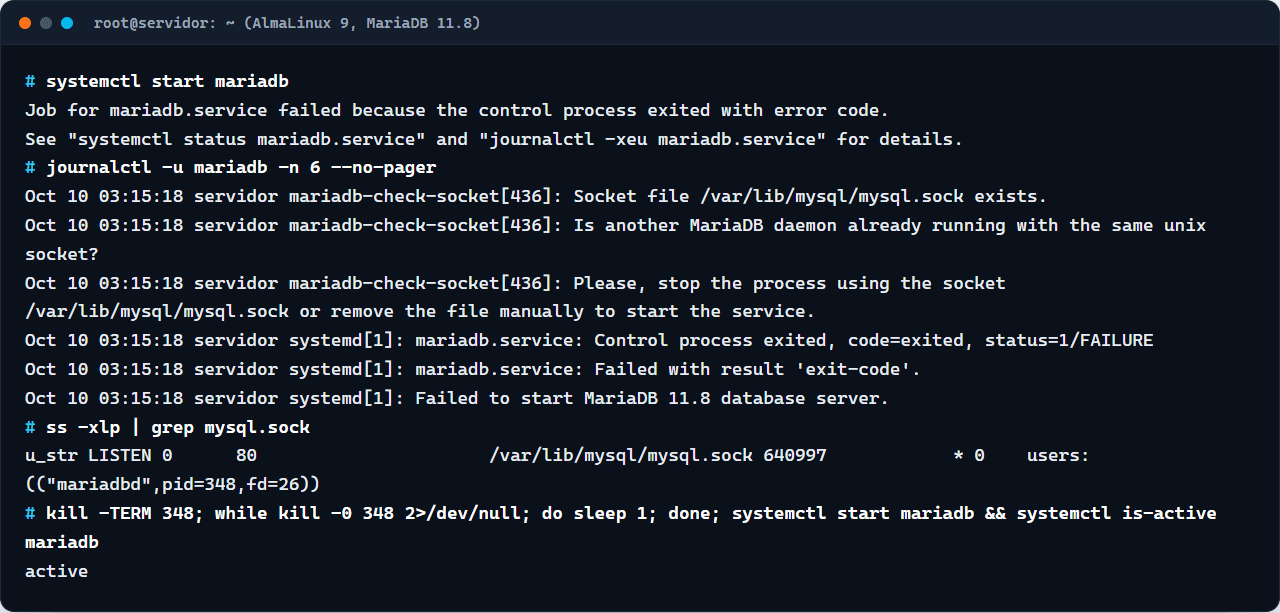
Isso acontece quando alguém iniciou o banco à mão, fora do systemd, ou quando sobrou uma instância antiga rodando. A solução é achar o processo, encerrá-lo de forma limpa (kill -TERM, nunca kill -9 de cara) e iniciar pelo systemctl:
ss -xlp | grep mysql.sock
ps -o pid,user,etime,cmd -C mysqld,mariadbd
kill -TERM <PID>
systemctl start mariadbO conselho antigo de renomear o mysql.sock só vale quando nenhum processo usa o arquivo. E hoje nem é preciso: no nosso teste, depois de um kill -9 no MariaDB, o próprio script detectou o socket órfão e o serviço voltou sozinho:
mariadb-check-socket[598]: Socket file /var/lib/mysql/mysql.sock exists.
mariadb-check-socket[598]: No process is using /var/lib/mysql/mysql.sock, which means it is a garbage, so it will be removed automatically.
systemd[1]: Started MariaDB 11.8 database server.No MySQL 8.4, o sintoma é outro: "Unable to lock ./ibdata1 error: 11"
Com o MySQL 8.4 do AlmaLinux 9, repetimos o teste com uma segunda instância iniciada à mão. O script de checagem não enxergou o processo (o binário do mysqld tem uma capability extra, e o processo fica protegido contra inspeção pelo usuário mysql), tratou o socket como lixo e deixou o serviço tentar subir. O MySQL passou mais de um minuto e meio tentando travar os arquivos do InnoDB e desistiu:
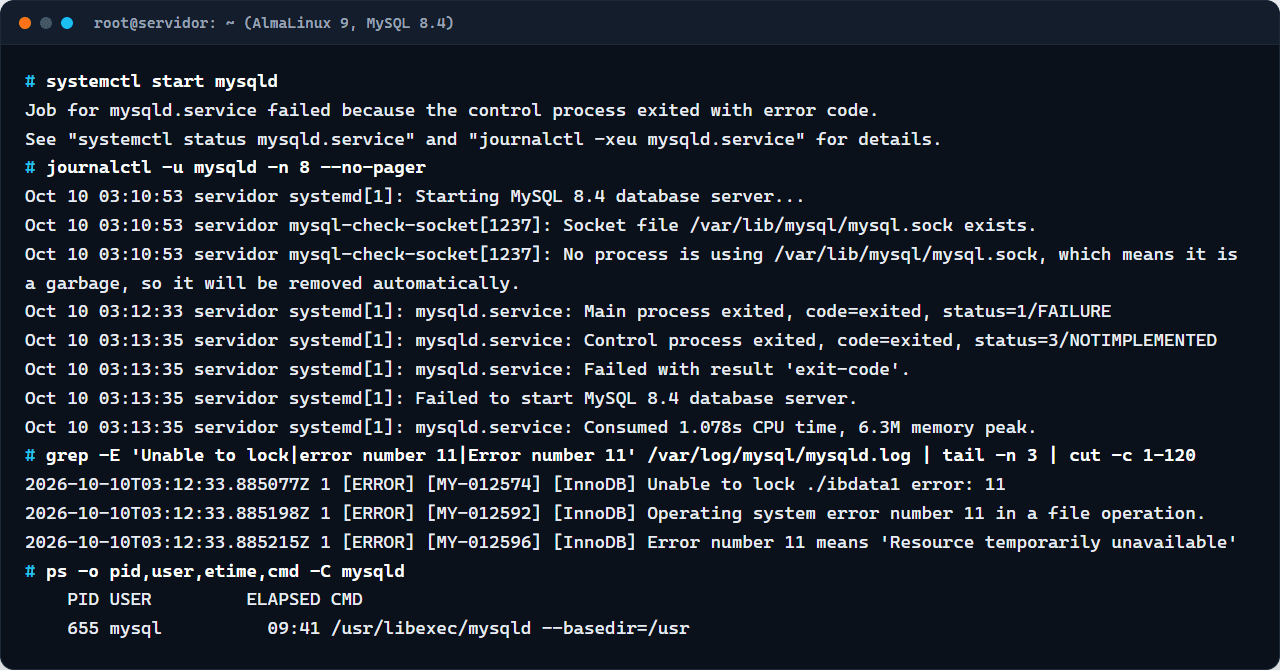
Se o seu log mostra "Unable to lock ./ibdata1 error: 11", procure outro mysqld com ps -C mysqld e encerre-o com kill -TERM antes de iniciar o serviço. O InnoDB recusa abrir arquivos que outra instância está usando, e é isso que protege os dados.
Outra variação do MySQL 8 aparece quando sobra o arquivo mysql.sock.lock de uma queda e o número de processo gravado nele passa a pertencer a outro programa:
[ERROR] [MY-010259] [Server] Another process with pid 2481 is using unix socket file.
[ERROR] [MY-010268] [Server] Unable to setup unix socket lock file.Confira com ps -p 2481 o que é esse processo. Se não for um mysqld, o arquivo de trava está velho: apague /var/lib/mysql/mysql.sock.lock e /var/lib/mysql/mysql.sock e inicie o serviço.
Porta 3306 ocupada
Se outro programa já escuta na porta do MySQL, o log é direto:
[ERROR] [MY-010262] [Server] Can't start server: Bind on TCP/IP port: Address already in use
[ERROR] [MY-010257] [Server] Do you already have another mysqld server running on port: 3306 ?Descubra quem está na porta com ss -ltnp 'sport = :3306'. Costuma ser uma instalação antiga de MySQL ou MariaDB ainda ativa, ou um contêiner publicando a 3306. Pare o outro serviço ou mude a porta de um deles na linha port do my.cnf.
Disco cheio (Error number 28)
Disco cheio nem sempre impede a partida. No nosso teste, com a partição do banco a 99%, o MySQL 8.4 subiu e o systemctl mostrou active, mas o log encheu de erros 28 do InnoDB:
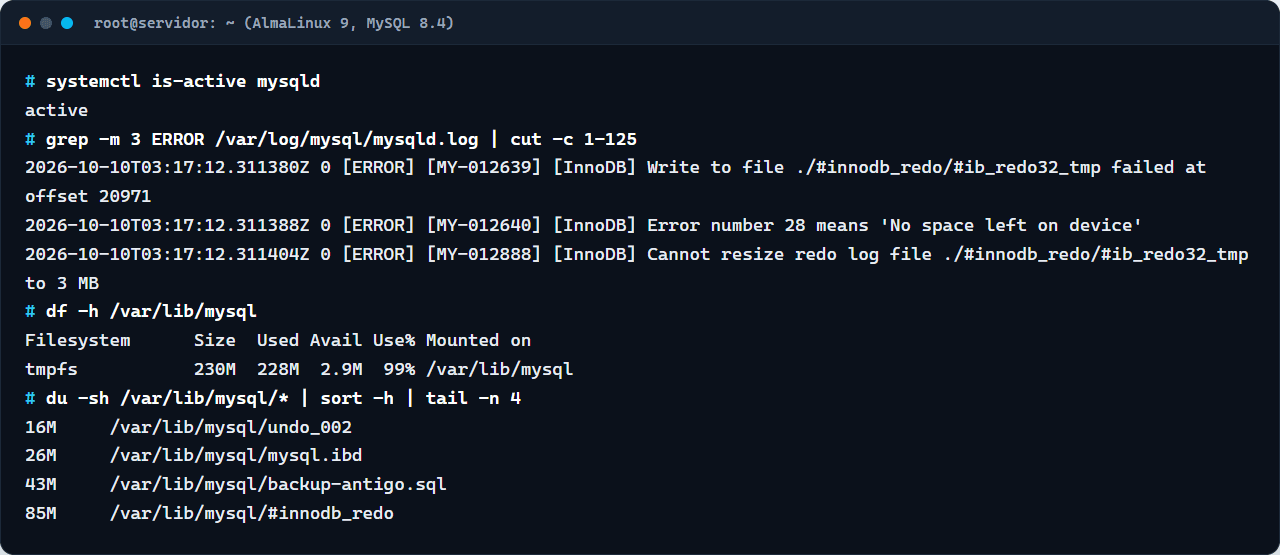
Libere espaço antes de qualquer outra coisa: backups antigos esquecidos, logs e logs binários. No MySQL 8.4, o log binário vem ligado por padrão e guarda 30 dias (binlog_expire_logs_seconds = 2592000), o que pesa em bancos com muita escrita. Para apagar os antigos do jeito certo, dentro do MySQL:
SHOW BINARY LOGS;
PURGE BINARY LOGS BEFORE NOW() - INTERVAL 7 DAY;Se houver réplicas, confira antes até qual log elas já leram. Nunca apague arquivos binlog.0000xx direto pelo shell: o arquivo de índice fica inconsistente.
InnoDB corrompido: innodb_force_recovery como último recurso
Depois de queda de energia ou falha de disco, o log pode mostrar erros de página corrompida ou de recuperação do InnoDB. A documentação do MySQL orienta, nessa ordem: fazer uma cópia do diretório de dados, iniciar com innodb_force_recovery = 1 no [mysqld] do my.cnf e subir o valor de um em um só se precisar, apenas para conseguir exportar os dados.
[mysqld]
innodb_force_recovery = 1Com qualquer valor acima de zero, o InnoDB bloqueia INSERT, UPDATE e DELETE. Valores de 4 para cima podem corromper os arquivos de vez e só devem ser usados depois de testados numa cópia. Exporte com mysqldump, recrie o banco limpo, importe e remova a opção.
É nesse ponto que um backup recente separa um susto de um prejuízo. Se você quer um servidor para banco de dados sem montar sozinho a rotina de backup e de monitoramento, o VPS Assistido entrega a VPS pronta, com backups periódicos, monitoramento e ajuda técnica mensal. Quem prefere administrar tudo tem o VPS Linux com acesso root e NVMe.
Perguntas frequentes
Como resolver "MySQL daemon failed to start"?
Leia o log de erros do MySQL e corrija a causa que aparece logo antes da linha "Aborting". No AlmaLinux e no Rocky, o log fica em /var/log/mysql/mysqld.log; no Ubuntu e no Debian, em /var/log/mysql/error.log. As causas mais comuns são permissão no /var/lib/mysql (errno 13), disco cheio (erro 28), outra instância usando o socket ou os arquivos e a porta 3306 ocupada.
O que fazer com "Another MySQL daemon already running with the same unix socket"?
Descubra qual processo usa o socket com ss -xlp | grep mysql.sock, encerre esse processo com kill -TERM e inicie o banco pelo systemctl. Se nenhum processo usa o socket, ele é um resto de uma queda: os scripts atuais do AlmaLinux e do Rocky o tratam como lixo automaticamente, e apagar o arquivo à mão também resolve.
Posso usar mysql_install_db para corrigir o erro?
Não. O mysql_install_db foi removido no MySQL 8.0, e o substituto, mysqld --initialize, cria um banco novo e vazio; ele se recusa a rodar num diretório de dados que já tem arquivos. Inicializar de novo só faz sentido numa instalação nova, nunca para recuperar um banco que parou de subir.
Qual é o comando para ver o erro do MySQL no systemd?
Use systemctl status mysqld para ver o resumo e journalctl -u mysqld -n 50 --no-pager para o histórico do serviço. O detalhe do erro do banco, porém, fica no log do próprio MySQL; no Ubuntu e no Debian, troque mysqld por mysql nos comandos, e no MariaDB use mariadb.
Leia também
- Linux e SSHComandos SSH para servidor cPanel/WHM em 2026: scripts, whmapi1 e LinuxSeleção dos comandos SSH que um administrador de servidor cPanel/WHM usa no dia a dia em 2026: atualizar, reiniciar serviços, empacotar e suspender contas, consultar o WHM pelo whmapi1 e achar o que lota o disco, pesa na CPU ou aparece nos logs. O CentOS saiu de cena; veja os sistemas aceitos hoje.8 min de leitura10/10/2026
- Linux e SSHPartição /tmp 100% cheia no servidor Linux com cPanel: como resolverCom o /tmp cheio, uploads falham, sessões de PHP param de funcionar e o banco de dados pode recusar consultas. Veja como achar o culpado e liberar espaço sem apagar o que está em uso.3 min de leitura10/10/2026
- Primeiros passosVPS ou servidor dedicado: diferenças e como escolherO VPS é um servidor virtual com recursos reservados dentro de uma máquina maior; o dedicado é a máquina inteira só para você. A escolha depende de carga, previsibilidade e orçamento.4 min de leitura10/10/2026
VPS para banco de dados
VPS Linux com acesso root e NVMe para rodar MySQL ou MariaDB do seu jeito. Prefere não cuidar sozinho? O VPS Assistido vem pronto, com backups periódicos e monitoramento.